
제78회 프랑크푸르트 도서전이 10월 7일 개막했다. 독일출판서점협회는 개막 전날인 6일 생성형 AI에 관한 「프랑크푸르트 호소문」을 내놓았다. 호소문은 EU 집행위원회·유럽의회·독일 연방정부에 작품별 학습 데이터 공개, 공정한 수익 모델의 라이선스 시장, 저작권 집행력 강화를 요구했다. 발표 당시 출판사 120곳이 지지했고, 8일 서명 명단에는 유럽출판인연맹·국제출판협회 등 출판 단체를 포함해 140곳이 올라 있다. 협회 보도자료와 호소문 원문에 담긴 내용이다.
프랑크푸르트 도서전 호소문, 요구는 데이터 공개·라이선스·집행 세 가지
호소문이 겨냥한 것은 AI 학습 자체가 아니라 학습의 조건이다. 협회는 AI 기업이 출판사·저자의 동의와 보상 없이 저작물로 모델을 학습시키는데도, 어떤 작품을 썼는지 공개할 법적 의무가 없다고 짚었다. 결국 권리자가 직접 증거를 모아 소송으로 권리를 주장해야 한다는 얘기다. 제바스티안 구골츠 협회장은 보도자료에서 권리자가 이를 “고비용 절차”로 관철해야 하는 처지라고 설명했고, 호소문은 소송이 유럽 대다수 출판사에는 “사실상 선택지가 아니다”라고 적었다.
| 요구 | 내용(호소문 원문 요지) |
|---|---|
| 학습 데이터 공개 | AI 기업 투명성 의무에 작품별 구체적 학습 데이터 공개를 포함 |
| 라이선스 시장 | 공정한 수익 모델의 라이선스 시장 개발. 텍스트·데이터 마이닝 규정으로 사실상 무상 이용 |
| 저작권 집행 | 유럽 저작권법 준수와 집행력 강화 |
수신: EU 집행위원회·유럽의회·독일 연방정부. 자료: 독일출판서점협회
셋째 요구에는 호소문의 문제의식이 압축돼 있다. 호소문은 침해해도 아무 일이 없는 권리는 “아무 가치가 없다”고 썼다. 첫째 요구의 배경으로는 현행 AI 사업자 일반 지침이 EU AI법의 요구에 못 미친다는 점을 들었다. 둘째 요구에 대해서는 텍스트·데이터 마이닝 규정 때문에 AI 사업자가 사실상 대가 없이 저작물을 쓸 수 있다고 지적했다.
서명 수는 시점과 구성을 함께 봐야 한다. 6일 협회 발표 당시에는 출판사 120곳이었고, 8일 열람한 명단은 140곳이다. 늘어난 명단에는 소비자 단체와 국제 출판 단체가 들어 있고, 출판사는 독일어권이 다수다. 어디까지나 독일 출판계의 호소문이고, 세계 출판계가 합의한 내용은 아니다.
법원은 라이선스를 받았어야 한다고 봤고, 집단 라이선스 상품도 나와 있다
요구가 허공에 뜬 주장은 아니다. 독일 뮌헨 지방법원은 2025년 11월 11일 1심 판결에서 ChatGPT의 학습·운영이 독일 음악 저작권 단체 GEMA 레퍼토리의 노랫말 저작권을 침해했다고 판단했다. 보호받는 노랫말을 저장하고 출력하는 일까지 텍스트·데이터 마이닝 허용 규정으로 정당화할 수는 없다는 판단이다. 책이 아니라 노랫말을 다룬 사건이다. GEMA는 판결 성명에서 카이 벨프 법무총괄의 말을 빌려 “기술 대기업도 지식재산을 쓰려면 라이선스를 취득해야 한다”고 밝혔다. 다만 오픈AI가 2025년 12월 8일 항소해 판결은 아직 확정되지 않았다. 벨프 법무총괄은 8일 협회가 도서전에서 연 패널 「먼저 소송, 그다음 규제?」에도 참석했다.
시장 쪽에서는 이미 상품이 나와 있다. 미국 저작권 라이선스 기관 CCC(Copyright Clearance Center)는 “AI 시스템 학습용 라이선스”라는 이름으로 자발적·비독점 집단 라이선스를 운영하고 있고, 7일 도서전에서 출판사의 AI 가치사슬 대응 전략을 주제로 패널을 열었다. 트레이시 암스트롱 CCC 회장 겸 CEO는 9월 29일 행사를 예고하는 보도자료에서 “책임 있는 AI가 라이선싱으로 확장되는 방식”을 논의하길 기대한다고 밝혔다. 같은 보도자료는 이 라이선스가 건건이 협상해야 하는 부담을 덜기 위한 것이라고 설명했다.
EU 집행위원은 창의성과 기술 사이 택일을 거짓 선택이라 했다
정책 당국도 금지를 말하지는 않았다. 6일 개막식에서 글렌 미칼레프 EU 세대간형평·청년·문화·스포츠 담당 집행위원은 창의성과 기술 중 하나를 고르는 것은 “거짓 선택”이라고 말했다. AI가 연구를 돕고 반복 작업을 맡을 수는 있어도 “무엇을, 왜 말할지” 정해서는 안 된다는 것이다. 창작물 라이선스의 실효성을 높이고, 권리자의 동의와 공정한 보상을 보장하는 일은 기업의 책임이라고도 했다. 같은 자리에서 볼프람 바이머 독일 연방 문화·미디어 국무장관은 무보상 이용을 “지적 흡혈”에 빗댔다. 이 표현은 영문으로 전해진 발언을 옮긴 것이다. 바이머 국무장관은 지식재산은 EU 차원에서 함께 대응해야만 효과적으로 보호할 수 있다고 밝혔다.
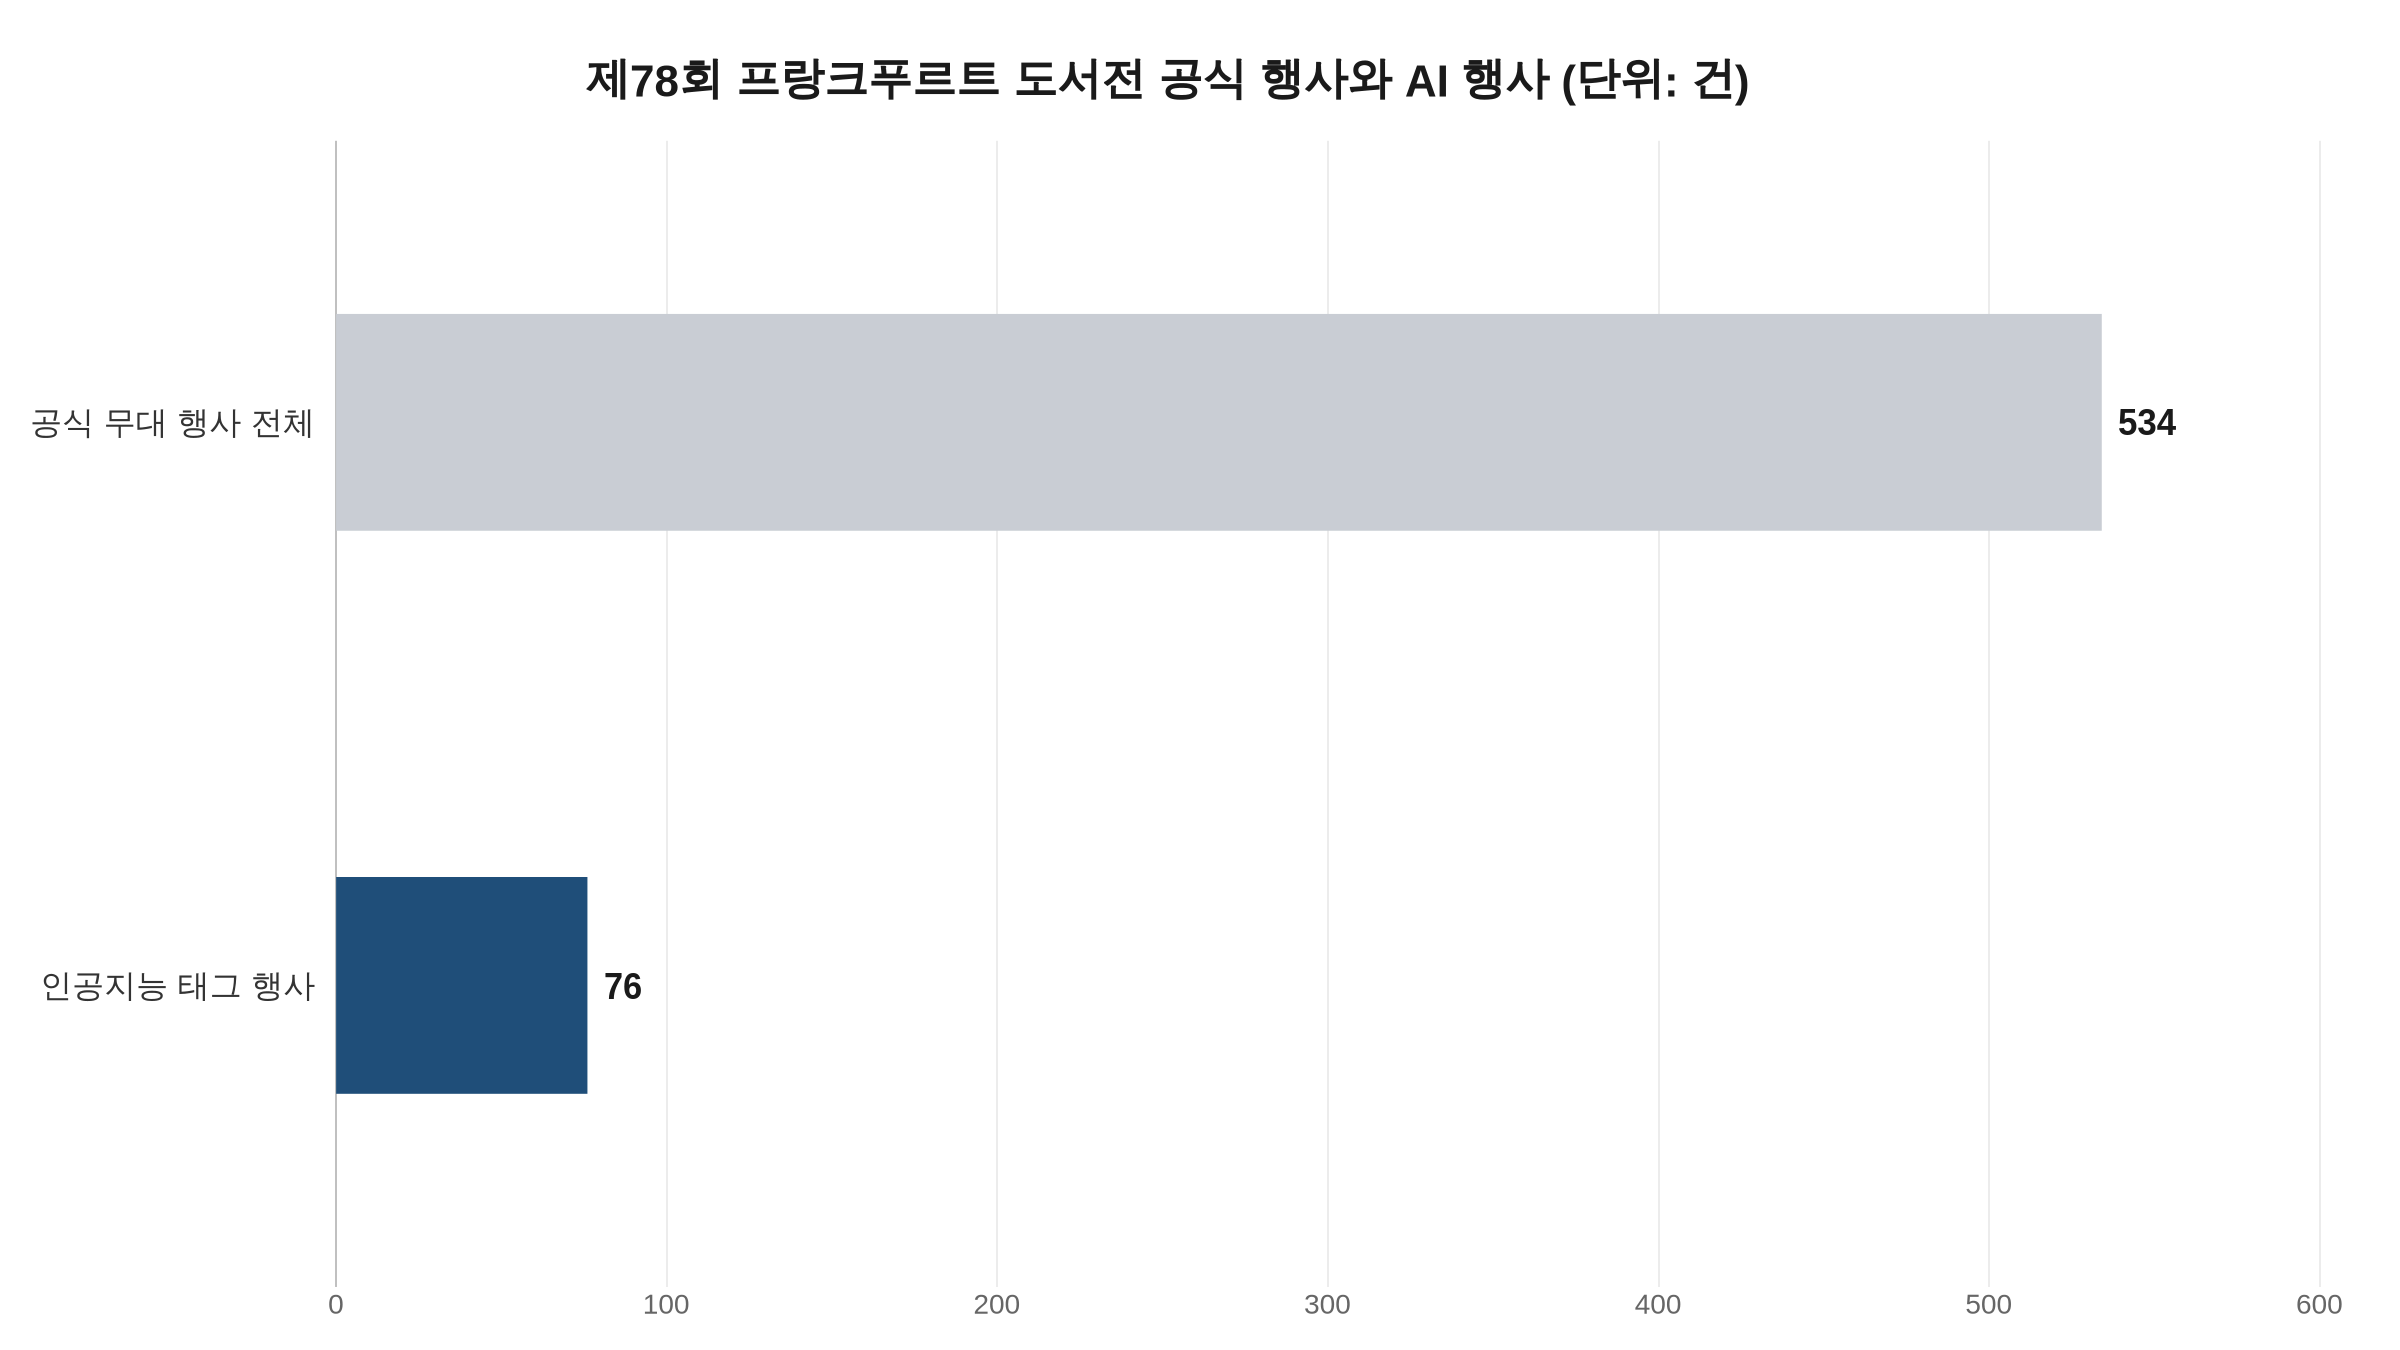
도서전 자체도 AI와 거리를 두지 않았다. 프레스킷(9월 14일 기준)에 따르면 이번 도서전의 공식 무대 행사 534건 중 인공지능 태그가 붙은 행사는 76건이다. 도서전과 도스도세닷컴이 9월 4일 낸 오디오북 백서는 85명 넘는 업계 전문가와 논의한 결과, 응답자의 85%가 오디오북 제작의 한 단계 이상에서 AI를 쓴다고 전했다. 여섯 단계 넘게 AI를 쓴다는 응답자도 17%였다. 이 수치는 백서에 응답한 전문가 기준이다.
책 다음은 사고…구골츠와 르포어가 던진 질문
협회의 문제 제기는 저작물 이용료에서 끝나지 않는다. 협회 보도자료의 제목은 「AI의 이중 약탈: 먼저 책, 그다음 사고」다. 구골츠 협회장은 정치가 지금 움직이지 않으면 AI가 저작물을 계속 빼앗을 뿐 아니라 장기적으로 “우리의 사고”까지 빼앗을 것이라고 경고했다. 의미를 파악하며 읽지 못하는 사람은 AI의 답을 “검증할 수 없다”는 지적도 덧붙였다. 협회는 최근 PISA에서 15세 3분의 1이 충분히 읽지 못했고, 2025년 10~15세 도서 구매자 수가 전년보다 30.6% 줄었다는 수치를 근거로 들었다. 학교에 매일 정해진 읽기 시간을 도입하고 미디어 역량을 필수 과목으로 삼자는 요구는 호소문에 들어 있지 않고, 구골츠 협회장이 기자회견에서 따로 내놓았다.
도서전 기조연설에 나선 질 르포어 미국 역사학자(퓰리처상 수상자)는 세계의 책에 담긴 인류 지식의 총합이 기업이 소유한 기계에 “통째로 삼켜졌다”고 말했다. 읽고 쓰고 생각하는 일까지 기계에 넘길지는 “지금 결정해야 한다”고도 했다. 학습 데이터 공개와 대가 지급만으로는 풀리지 않는 우려다. AI 기업 측의 직접 반응은 확인되지 않았다.
한국에서는 앞서 출판계가 자율 원칙을 내놓았다. 국내 보도에 따르면 이 원칙에는 출판물이 AI 학습에 이용될 때 권리자의 동의와 정당한 보상이 전제된다는 내용이 담겼다. 김보경 한국출판인회의 정책위원장(지와인 대표)은 출판계가 자율 표시 기준을 세우고 지키는 과정이 정부와 AI 기업을 상대로 “협상력을 확보하는 토대”가 된다고 밝혔다.
한국출판인회의 등 12개 단체가 9월 29일 마포중앙도서관 정책포럼에서 발표한 「독자를 위한 출판사와 저작자의 AI 사용 원칙」은 5장 20조로 구성됐으며 법적 구속력은 없다.
연관 기사