
오픈AI가 16일(현지시간) 병원·보험사 등 의료팀이 쓰는 컴퓨터 사용 에이전트를 공개했다(오픈AI 발표). 화면을 클릭·입력하고 앱 사이를 오가며 사전 승인 요청, 의뢰, 퇴원 계획 같은 다단계 업무를 처리한다. 회사는 의사들이 전자의무기록(EHR) 받은편지함 작업 325건을 검토해 99%를 안전하다고 판정했다고 밝혔다. 오픈AI 자체 평가다.
99%는 부정확한 내용이나 누락, 작업 중 행동이 환자 피해로 이어질 수 있는지를 의사가 가린 비율이다. 환자 결과나 진단 정확도를 잰 값이 아니다. 별도로 5점 척도로 평가한 646건에서는 93%가 매우 또는 극히 도움이 됐다는 응답이었다. 평가 기간과 참여한 의사 수는 공개되지 않았다.
에이전트는 오픈AI API, ChatGPT for Healthcare, ChatGPT for Clinicians에서 미국 내 사용자가 쓸 수 있다. 초기 도입 기업은 Abridge, Ambience, Cigna Healthcare, CVS Health다. Ambience는 보험사 포털에서 사전 인증 요청서를 작성할 때 에이전트를 쓰는데, 기록이 모호하면 멈춰 임상의에게 확인하고 승인 전에는 제출하지 않는다. Cigna Healthcare에서는 사례 관리자가 10개 이상 시스템을 오가며 모으던 정보를 에이전트가 통합한다. 회사는 역할 기반 접근 제어, 감사 로그, 승인 단계를 두고 조직 데이터는 모델 학습에 쓰지 않는다고 밝혔다.
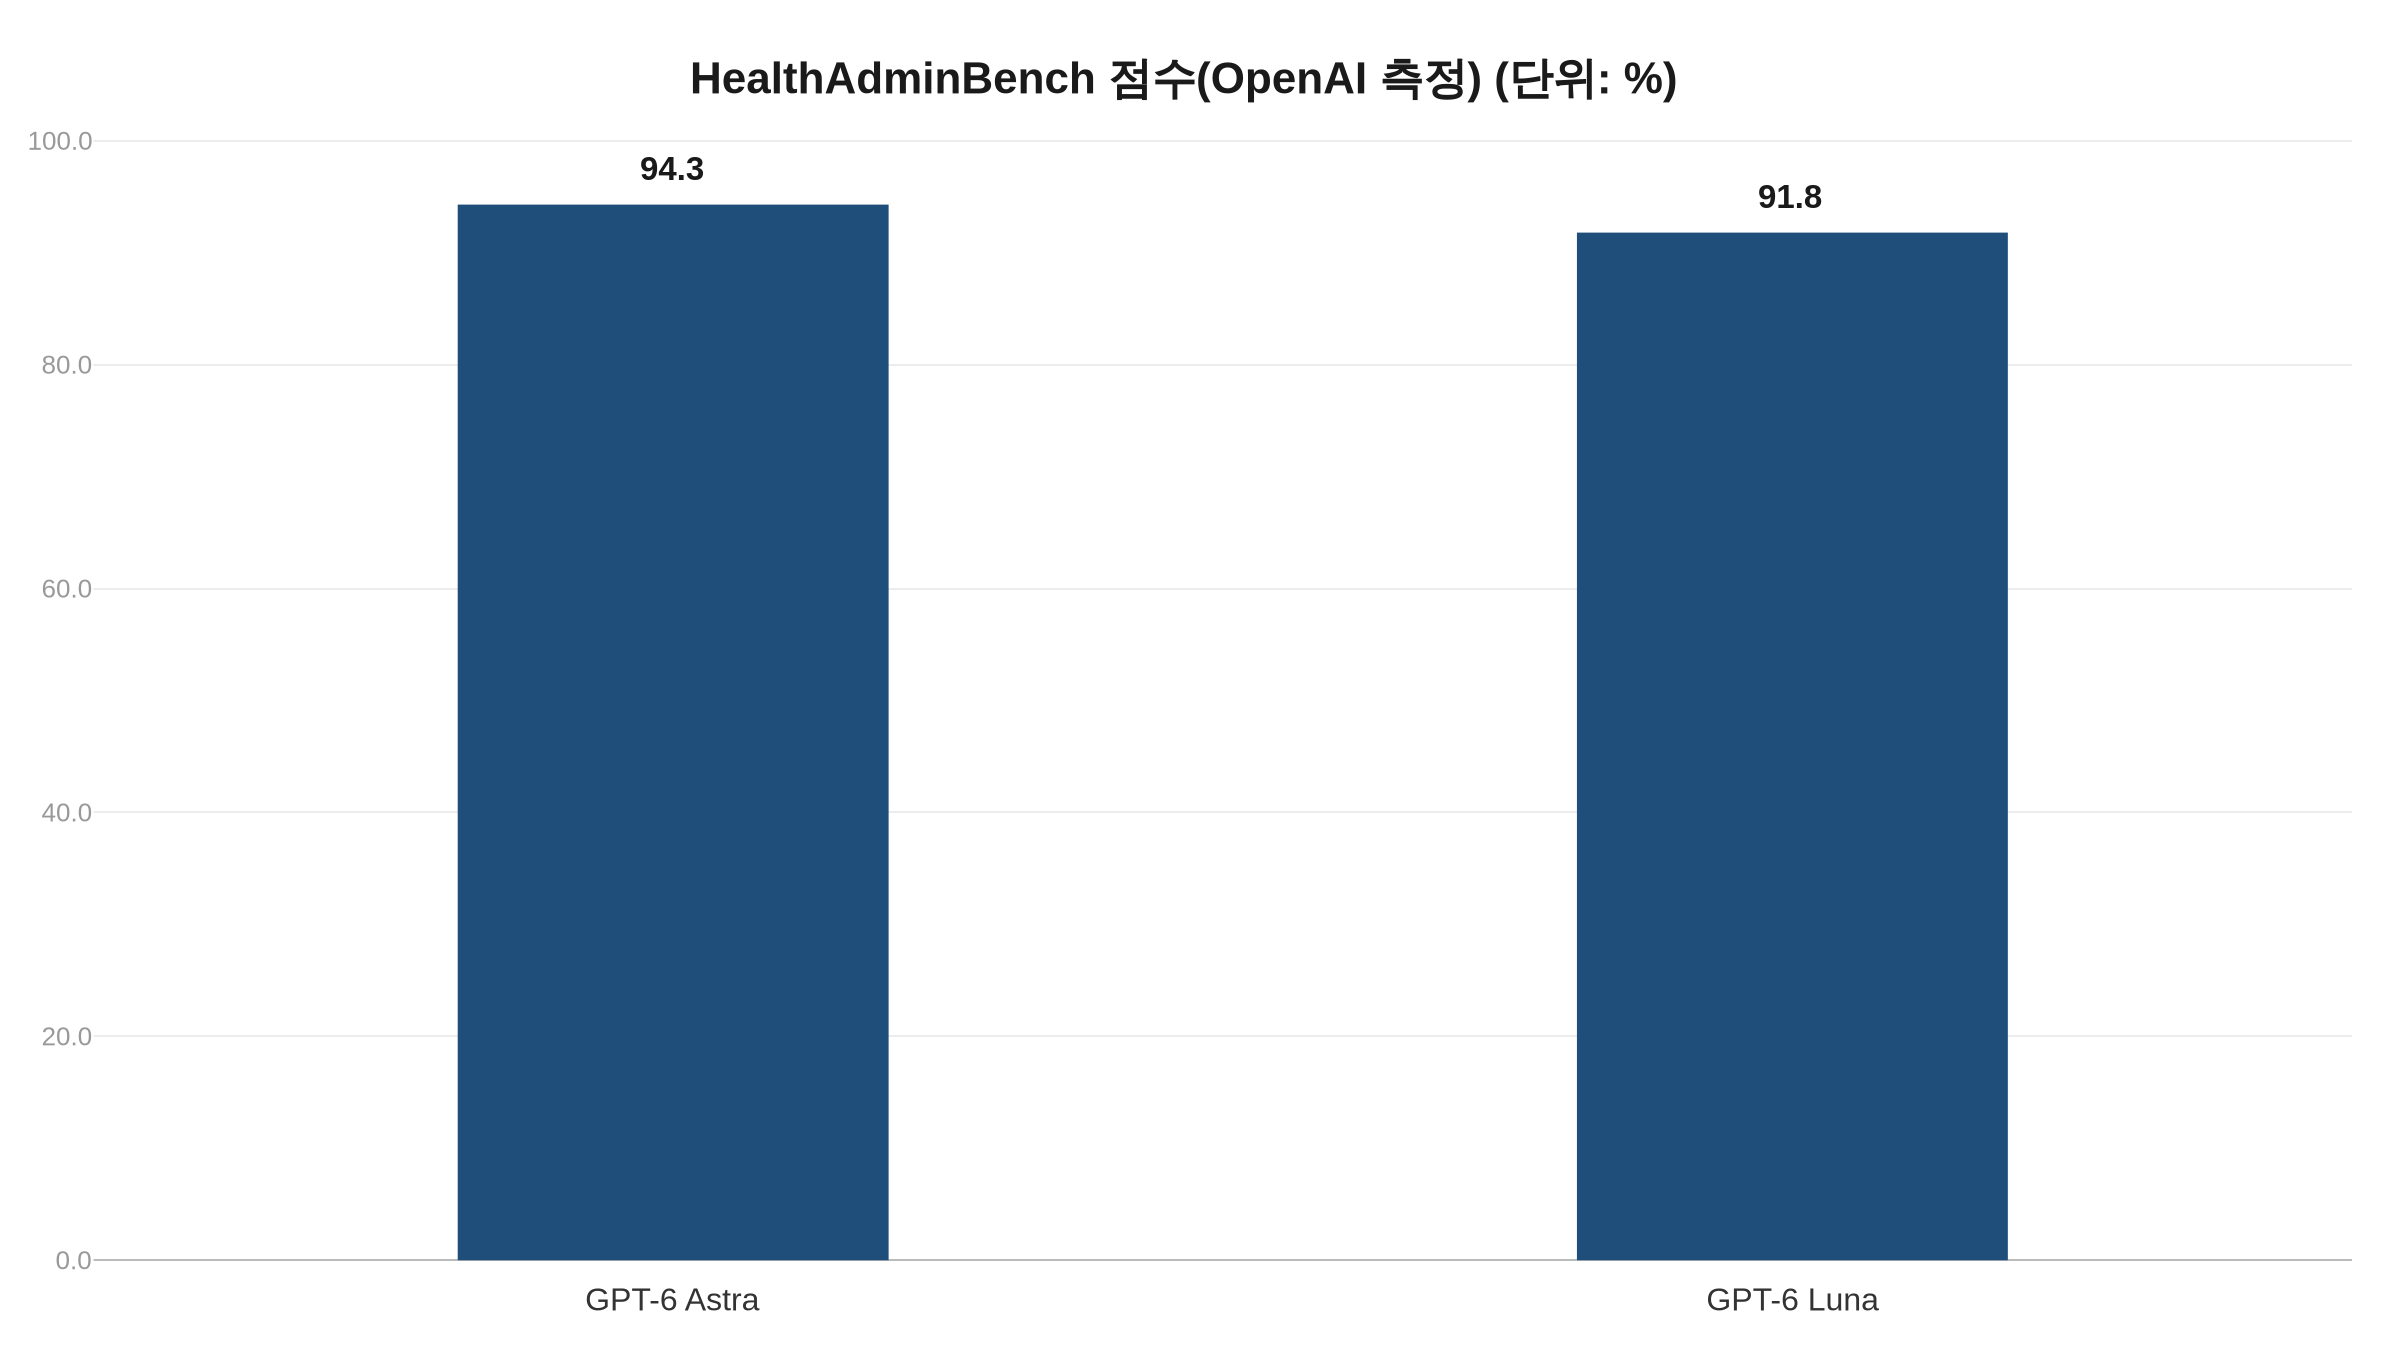
스탠퍼드 연구진이 만든 의료 행정 업무 벤치마크 HealthAdminBench에서 오픈AI가 직접 측정한 점수는 GPT-6 Astra가 94.3%, GPT-6 Luna가 91.8%였다. Luna는 작업당 8.5센트로 Astra보다 비용이 98% 낮다고 회사는 밝혔다.
오픈AI 의료 에이전트와 같은 날 나온 플러그인 20개 이상
오픈AI는 같은 날 ChatGPT for Healthcare에 의료 플러그인 20개 이상을 추가하고 임상 검색을 개선한다고 별도로 발표했다. 분야는 임상 진료·진료 조정·사업 운영이다. 플러그인에는 UpToDate Expert AI, Metriport, IMO Health, Stedi 등이 포함됐다. 워크스페이스 관리자가 활성화하며 검증된 미국 임상의는 무료 ChatGPT for Clinicians 계정으로 신규 플러그인 일부만 쓸 수 있다.
임상 검색에서는 의학 근거를 찾고 평가하고 인용하는 방식을 손봤다. 회사는 의사 블라인드 리뷰 1,300건 이상에서 개선판이 8개 항목 모두 더 높은 평가를 받았다고 밝혔다. 이 리뷰는 임상 질의응답을 비교한 것이어서 앞의 EHR 업무 평가와는 대상이 다르다.
| 구분 | 대상 제품 | 핵심 내용 | 회사가 제시한 평가 |
|---|---|---|---|
| 컴퓨터 사용 에이전트 | 오픈AI API, ChatGPT for Healthcare, ChatGPT for Clinicians | 화면 클릭·입력으로 다단계 업무 | EHR 작업 325건 중 99% 안전, 646건 중 93% 도움(의사 검토) |
| 플러그인·임상 검색 | ChatGPT for Healthcare(Clinicians는 일부) | 의료 플러그인 20개 이상, 근거 검색·인용 개선 | 의사 리뷰 1,300건 이상, 8개 항목 상향(폭 미공개) |
두 발표의 수치는 모두 오픈AI 자체 평가이며, 독립 재현 결과는 공개되지 않았다. 8개 항목의 상향 폭과 평가에 참여한 의사 수, 에이전트 오류율, ChatGPT for Healthcare 가격도 오픈AI는 밝히지 않았다.
연관 기사