
OpenAI가 6일(현지시간, 한국 시간 7일 오전 7시) 공개하지 않은 내부 모델로 만든 수학 원고를 GitHub 저장소에 올렸다. 처음 722편이던 원고는 7일자 수정 기록에서 3편이 철회돼 현재 719편, 372개 결과 묶음으로 정리돼 있다. OpenAI는 수정 기록에 형식화된 최상위 결과가 약 42%(300/719)라고 적었다.
저장소는 형식화되지 않은 결과 일부에 문제가 있을 수 있다고 스스로 적었다. 기계가 검사하지 못한 나머지를 누가 어떻게 확인하느냐가 이번 공개의 쟁점이다.
Lean 형식화된 최상위 결과 약 42%…나머지는 사람이 읽어야
OpenAI는 형식화가 붙은 최상위 결과를 약 42%로 집계했고, 나머지는 사람 수학자가 읽고 확인해야 하는 상태로 공개했다. Lean 형식화는 증명을 컴퓨터가 검사할 수 있는 형태로 옮기는 작업이다. 이 비율은 첫 공개 때는 없었다. 6일 README에는 원고 상당수가 형식화됐지만 전부는 아니라는 문장만 있었고, 약 42%라는 수치는 7일자 갱신에서 나왔다.
원고가 나온 경위도 저장소에 적혀 있다. OpenAI는 모델을 평가하는 과정에서 약 4,000개 문제를 냈고, 결과마다 평균 ChatGPT Pro 사고 3시간 상당의 연산이 들었다고 밝혔다. 결과 하나당 평균 연산량이라는 얘기지, 722편을 3시간 만에 썼다는 말은 아니다. 이 가운데 일정한 중요도 기준을 통과한 결과를 372개 묶음으로 엮었다.
42%를 읽을 때는 분모와 분자의 단위부터 봐야 한다. 분모는 원고 719편이고 분자는 형식화된 최상위 결과다. 분자의 단위가 원고와 같은지는 기록에 없다. 원고의 42%가 검증됐다고 읽을 수 없는 이유다. 엄상일 IBS 이산수학그룹 CI도 형식화가 연결된 것은 42% 정도로 절반이 채 되지 않는다고 짚으면서, Lean의 한계를 이렇게 설명했다. “린이 보증하는 것은 린으로 읽을 수 있는 명제가 증명됐다는 사실뿐”이고, 그 명제가 논문의 주장과 일치하는지는 “사람이 읽어서 확인해야 한다”는 것이다. 엄상일 CI가 말한 42%도 같은 OpenAI 기록의 수치다.
공개 이튿날 3편 철회, 14편 수정
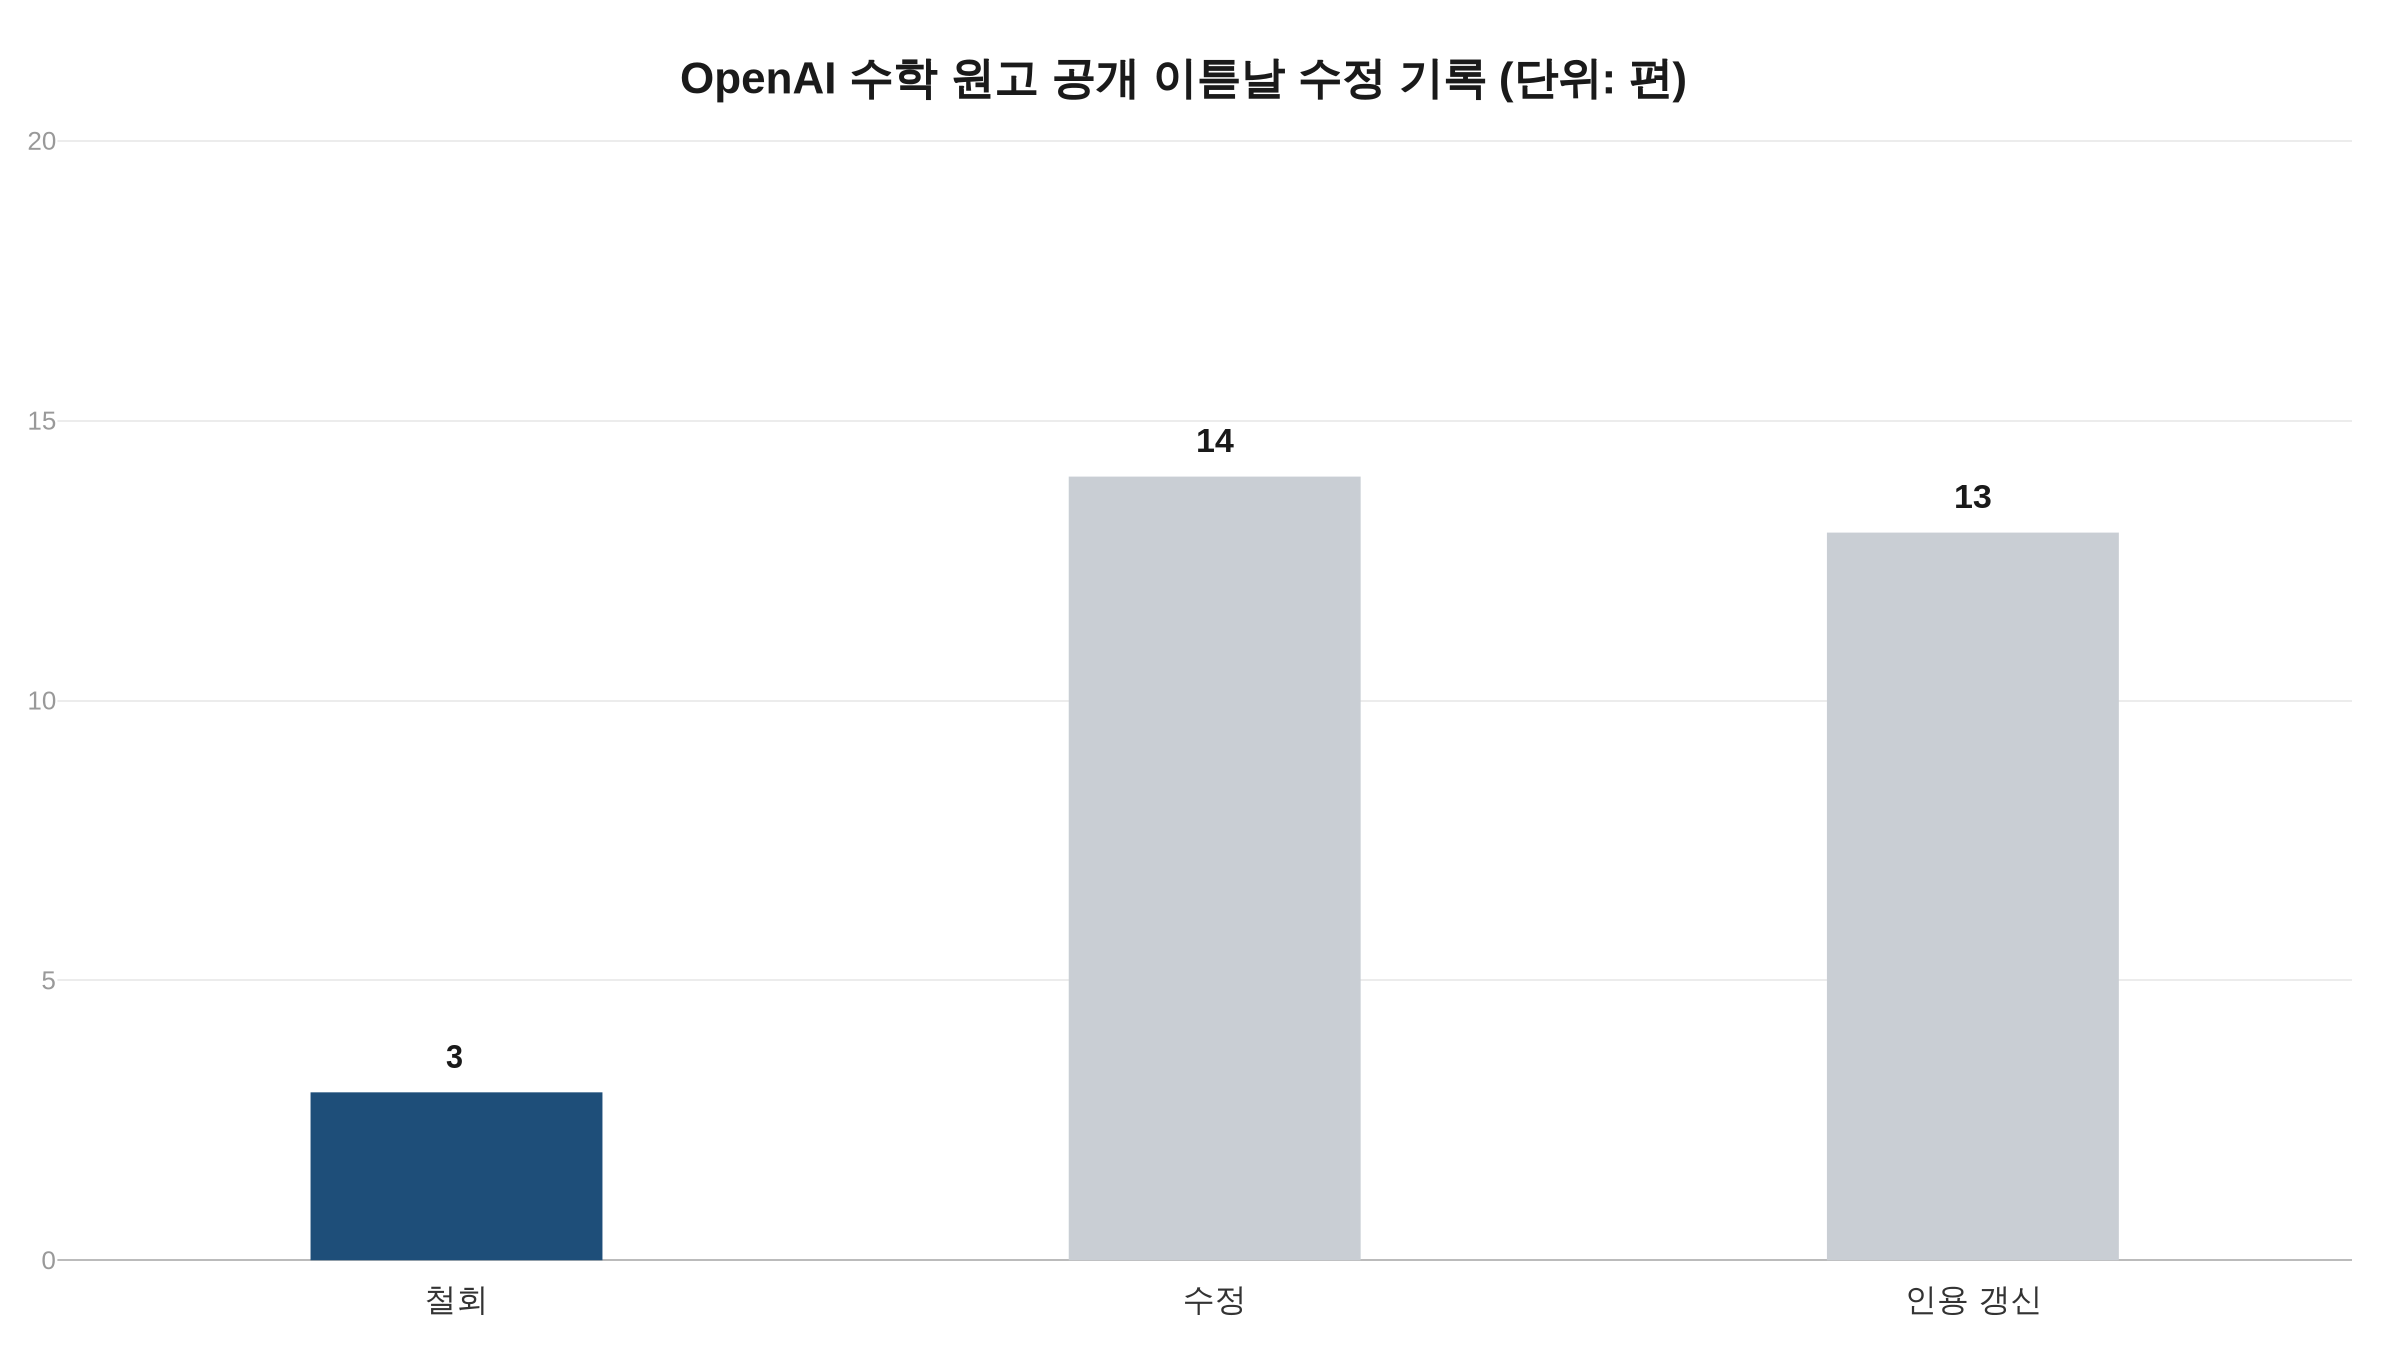
공개 뒤 실제로 확인된 오류는 저장소의 7일자 수정 기록에 있다. OpenAI는 「분할 아벨 8차원 다양체 위 베유 류의 대수성」(Algebraicity of Weil classes on split abelian eightfolds) 원고에 부호 오류가 있어, 안정화-대각합 상쇄 논증과 이를 쓴 원고 2편의 구성이 성립하지 않는다고 적고 3편을 철회했다. 이 원고들은 철회 공지와 보관본 링크가 남아 있다. 오류를 누가 발견했는지는 기록에 없다.
수정은 철회에 그치지 않았다. 증명 보수·명제 수정·가정 명확화 등으로 14편이 고쳐졌고, 그 결과 13편은 개정판을 인용하도록 갱신됐다. 같은 날 형식화 6건과 기타 5건이 추가돼 300/719라는 수치가 나왔다.
OpenAI는 수정을 새 버전으로 남기고 이전 판을 계속 열어 두겠다고 저장소에 적었다. 다만 정정 뒤에도 그 과정을 따라가는 일은 외부에 남는다. 앤드루 서덜랜드 MIT 수학자는 모델이 공개돼 다른 사람이 결과를 재현하기 전까지는 한 번에 풀었다는 주장을 “미검증”으로 봐야 한다고 말했다. 그는 연구소에 “영수증을 요구해야 한다”고도 했다.
자문그룹이 요구한 공개 항목과 OpenAI가 내놓은 자료
그 영수증에 무엇이 들어가야 하는지는 이미 문서로 정리돼 있다. 프린스턴 고등연구소(IAS)가 꾸린 수학·AI 자문그룹(AGMAI)은 9월 29일 권고를 냈다. 가워스·하이러·위튼 등 9명으로 구성된 이 그룹은 AI 기업에서 보수를 받지 않고 결정권도 없다고 스스로 밝혔다. 권고는 수학계에서 받은 600건 넘는 설문 응답을 반영했다. 응답자 범위는 밝히지 않았다.
권고의 핵심은 결과마다 모델명·프롬프트·사고 과정·소요 시간·추정 연산 비용을 공개하고, 대량 공개라면 실패한 비슷한 난도 문제의 수와 선정 방식을 문서화하라는 것이다. 연구소가 통제하지 않는 학술 저장소에 영구 식별자와 수정 기록을 붙여 올리라는 항목도 있다. OpenAI는 발표문에서 AGMAI의 조언과 공개 권고를 참고했다고 밝혔다. 권고 항목과 OpenAI 자료의 문언을 나란히 놓으면 이렇다.
| 권고 항목 | OpenAI 자료에 적힌 내용 |
|---|---|
| 모델명 | “공개하지 않은 내부 모델”로만 표기 |
| 프롬프트 | 저장소 문서에 언급 없음 |
| 사고 과정 | 10개 묶음의 추론 요약 공개 |
| 소요 시간·연산 비용 | 결과당 평균 ChatGPT Pro 사고 약 3시간 상당 |
| 시도·실패 문제 수 | 약 4,000개 문제를 제시했다고 기재, 실패 수는 별도 기재 없음 |
| 연구소 통제 밖 저장소 | GitHub의 OpenAI 계정, 커뮤니티 호스팅 저장소는 검토 중 |
자료: OpenAI 저장소 README·발표문(2026년 10월 6~7일), AGMAI 권고(2026년 9월 29일)
이 표에서 어느 항목을 지켰는지는 판정하지 않는다. AGMAI도 10월 6일 성명에서 권고가 얼마나 지켜졌는지는 “궁극적으로 수학계가 판단할 몫”이라고 했다. 자문 역할이 결과의 영향이나 OpenAI의 방식에 대한 승인으로 읽혀서는 안 되며, 이번 공개는 인간이 이해해 가는 과정의 “완성이 아니라 시작”이라는 설명도 붙였다. OpenAI 대변인은 권고를 진지하게 받아들이되 구속되지는 않는다는 입장을 밝혔다.
수학자 단체 인간수학협회(AHM) 커뮤니케이션 작업반은 더 강하게 반응했다. 작업반은 성명에서 700편이 넘는 파일을 한꺼번에 공개하는 것은 “학문의 증명이 아니라 힘의 과시”라며, 이번 공개가 학문을 진전시킨다는 OpenAI의 주장을 받아들이지 않는다고 했다.
필즈상급이라는 기대와 읽기 힘들다는 평
공개를 반기는 수학자도 있다. 대니얼 리트 토론토대 수학자는 문제의 답을 알고 싶다면 연구소가 그것을 우리에게 비밀로 하도록 둘 이유가 없다며, 이번 공개가 “수학에 좋은 일이 될 것”이라고 말했다.
국내 수학계의 시선도 한쪽으로 모이지 않는다. 백형렬 KAIST AI수학대학원장은 자기 연구 분야에서 “필즈상급이라고 할 만한 문제들이 여럿 포함”돼 있다고 평가했다. 그러면서도 직접 읽어본 원고들은 “읽기가 힘들었다”고 했고, 무엇을 기존 연구에서 가져왔고 무엇을 새로 했는지 “분명히 밝히는 일이 중요”하다고 짚었다.
기대하는 쪽과 우려하는 쪽은 결과의 가치를 두고 갈리지만, 기계 검증이 붙지 않은 결과를 사람이 읽고 확인해야 한다는 저장소의 설명은 그대로다.
OpenAI는 저장소를 수학계가 관리하는 곳으로 옮기는 방안을 검토 중이라고 밝혔고, AI가 낸 주요 결과를 이해하기 위한 워크숍·학회·특별 프로그램에 자금을 지원하겠다고 예고했다. 철회와 수정은 앞으로도 새 버전으로 기록한다.
연관 기사