
과학기술정보통신부가 9월 22일 서울에서 사이버보안 특화 AI 파운데이션 모델 개발 착수 간담회를 열었다. 네이버클라우드가 주관하는 컨소시엄에는 참여기관 33곳과 협력기관 8곳 등 41개 기관이 참여한다. 이날 간담회에서 1단계(2027년 2월 17일)·2단계(2027년 7월 17일) 평가 일정과 모델별 목표가 처음 공개됐다. 사업에 투입되는 그래픽처리장치(GPU) 4,512장 가운데 정부 지원분은 256장이다.
41개 기관·평가 두 차례, 간담회에서 나온 새 숫자
간담회는 22일 오후 3시 서울 소공동 더 그랜드 롯데 서울에서 열렸다. 정부와 참여기관이 개발 계획을 공유했고, 이어 참여사들이 자유토론을 벌였다. 과기정통부는 지난 7월 22일 공모를 시작해 8월 21일까지 접수를 받았다. 네이버클라우드 컨소시엄과 SK텔레콤 컨소시엄이 맞붙은 끝에 9월 3일 네이버클라우드가 최종 사업자로 선정됐다.
배경훈 부총리 겸 과기정통부 장관은 이날 “이번 사업은 우리가 직면한 사이버위협에 즉각 대응하기 위해 실제 보안현장에서 즉시 활용 가능한 글로벌급 모델을 과감하고 신속하게 개발하는 것이 목표”라고 말했다.
이 자리에서 처음 나온 건 사업 규모가 아니라 목표 일정과 평가 기준이었다. 1단계 평가는 2027년 2월 17일로 잡혔고, 학습 레시피 최적화와 평가 체계 확정이 목표다. 2단계 최종 평가는 2027년 7월 17일로, 협력사 실증을 마치고 모델을 최종 고도화하는 것이 목표다. 컨소시엄은 참여기관 33곳(주관사 포함)과 협력기관 8곳, 모두 41개 기관으로 꾸려졌다.
| 모델 | 역할 | 1단계(2027-02-17) | 2단계(2027-07-17) |
|---|---|---|---|
| 엑사원 기반 | 공격(레드팀)·취약점 발굴(사이버짐 벤치마크) | GLM 5.3 대비 80% | 100% |
| 하이퍼클로바X 기반 | 방어(블루팀)·침해사고 조사(방어 과제 벤치마크) | 그록4 수준 | 클로드 오퍼스 4.5 수준 |
자료: 네이버클라우드 컨소시엄 발표 목표치 (2026년 9월 22일)
공격 모델과 방어 모델이 서로를 가르친다
목표를 채우는 방식은 두 모델의 맞대결이다. 엑사원 기반 모델은 공격을 맡는 레드팀이다. 소스코드를 분석해 취약점과 공격 경로를 찾는다. 하이퍼클로바X 기반 모델은 방어를 맡는 블루팀으로, 위협 인텔리전스를 분석해 침해사고를 조사하고 대응책을 권고한다. 한쪽이 찾은 취약점은 상대 모델의 학습 데이터가 되고, 방어 결과는 다시 공격 모델 학습에 들어간다. 두 모델이 번갈아 서로를 가르치는 셈이다.
김진휘 네이버클라우드 보안전략담당 전무는 “방어를 강화한 하이퍼클로바X 모델, 공격을 강화한 엑사원 기반 모델을 동시에 개발하겠다”고 밝혔다.
두 모델의 매개변수 규모는 700B급 안팎이다. 하이퍼클로바X 기반 모델은 700B급으로 확인됐지만, 엑사원 기반 모델은 매체마다 700B급과 750B급으로 보도가 엇갈렸다. 실제 연산에 쓰이는 매개변수는 총 규모보다 작다. 두 모델 모두 입력마다 전체 매개변수 가운데 일부 ‘전문가’ 하위망만 활성화하는 전문가 혼합(MoE) 구조를 쓰기 때문이다. 실증은 전력·금융·과학기술·통신·반도체·방위산업·항공우주 등 7개 분야에서 진행된다.
레드팀 모델을 둘러싼 우려도 나온다. 김명주 인공지능안전연구소(AISI) 소장은 선정 전인 지난달 26일 인터뷰에서 “취약점을 찾고 공격 코드까지 만들면 (보안 특화 모델은) 공격용 AI가 되는 것”이라고 지적했다. 김 소장은 취약점을 찾아 패치 코드까지 만들어주는 방향으로 가야 방어용 모델이 된다고 봤다.
GPU 4,512장 가운데 정부 지원은 256장
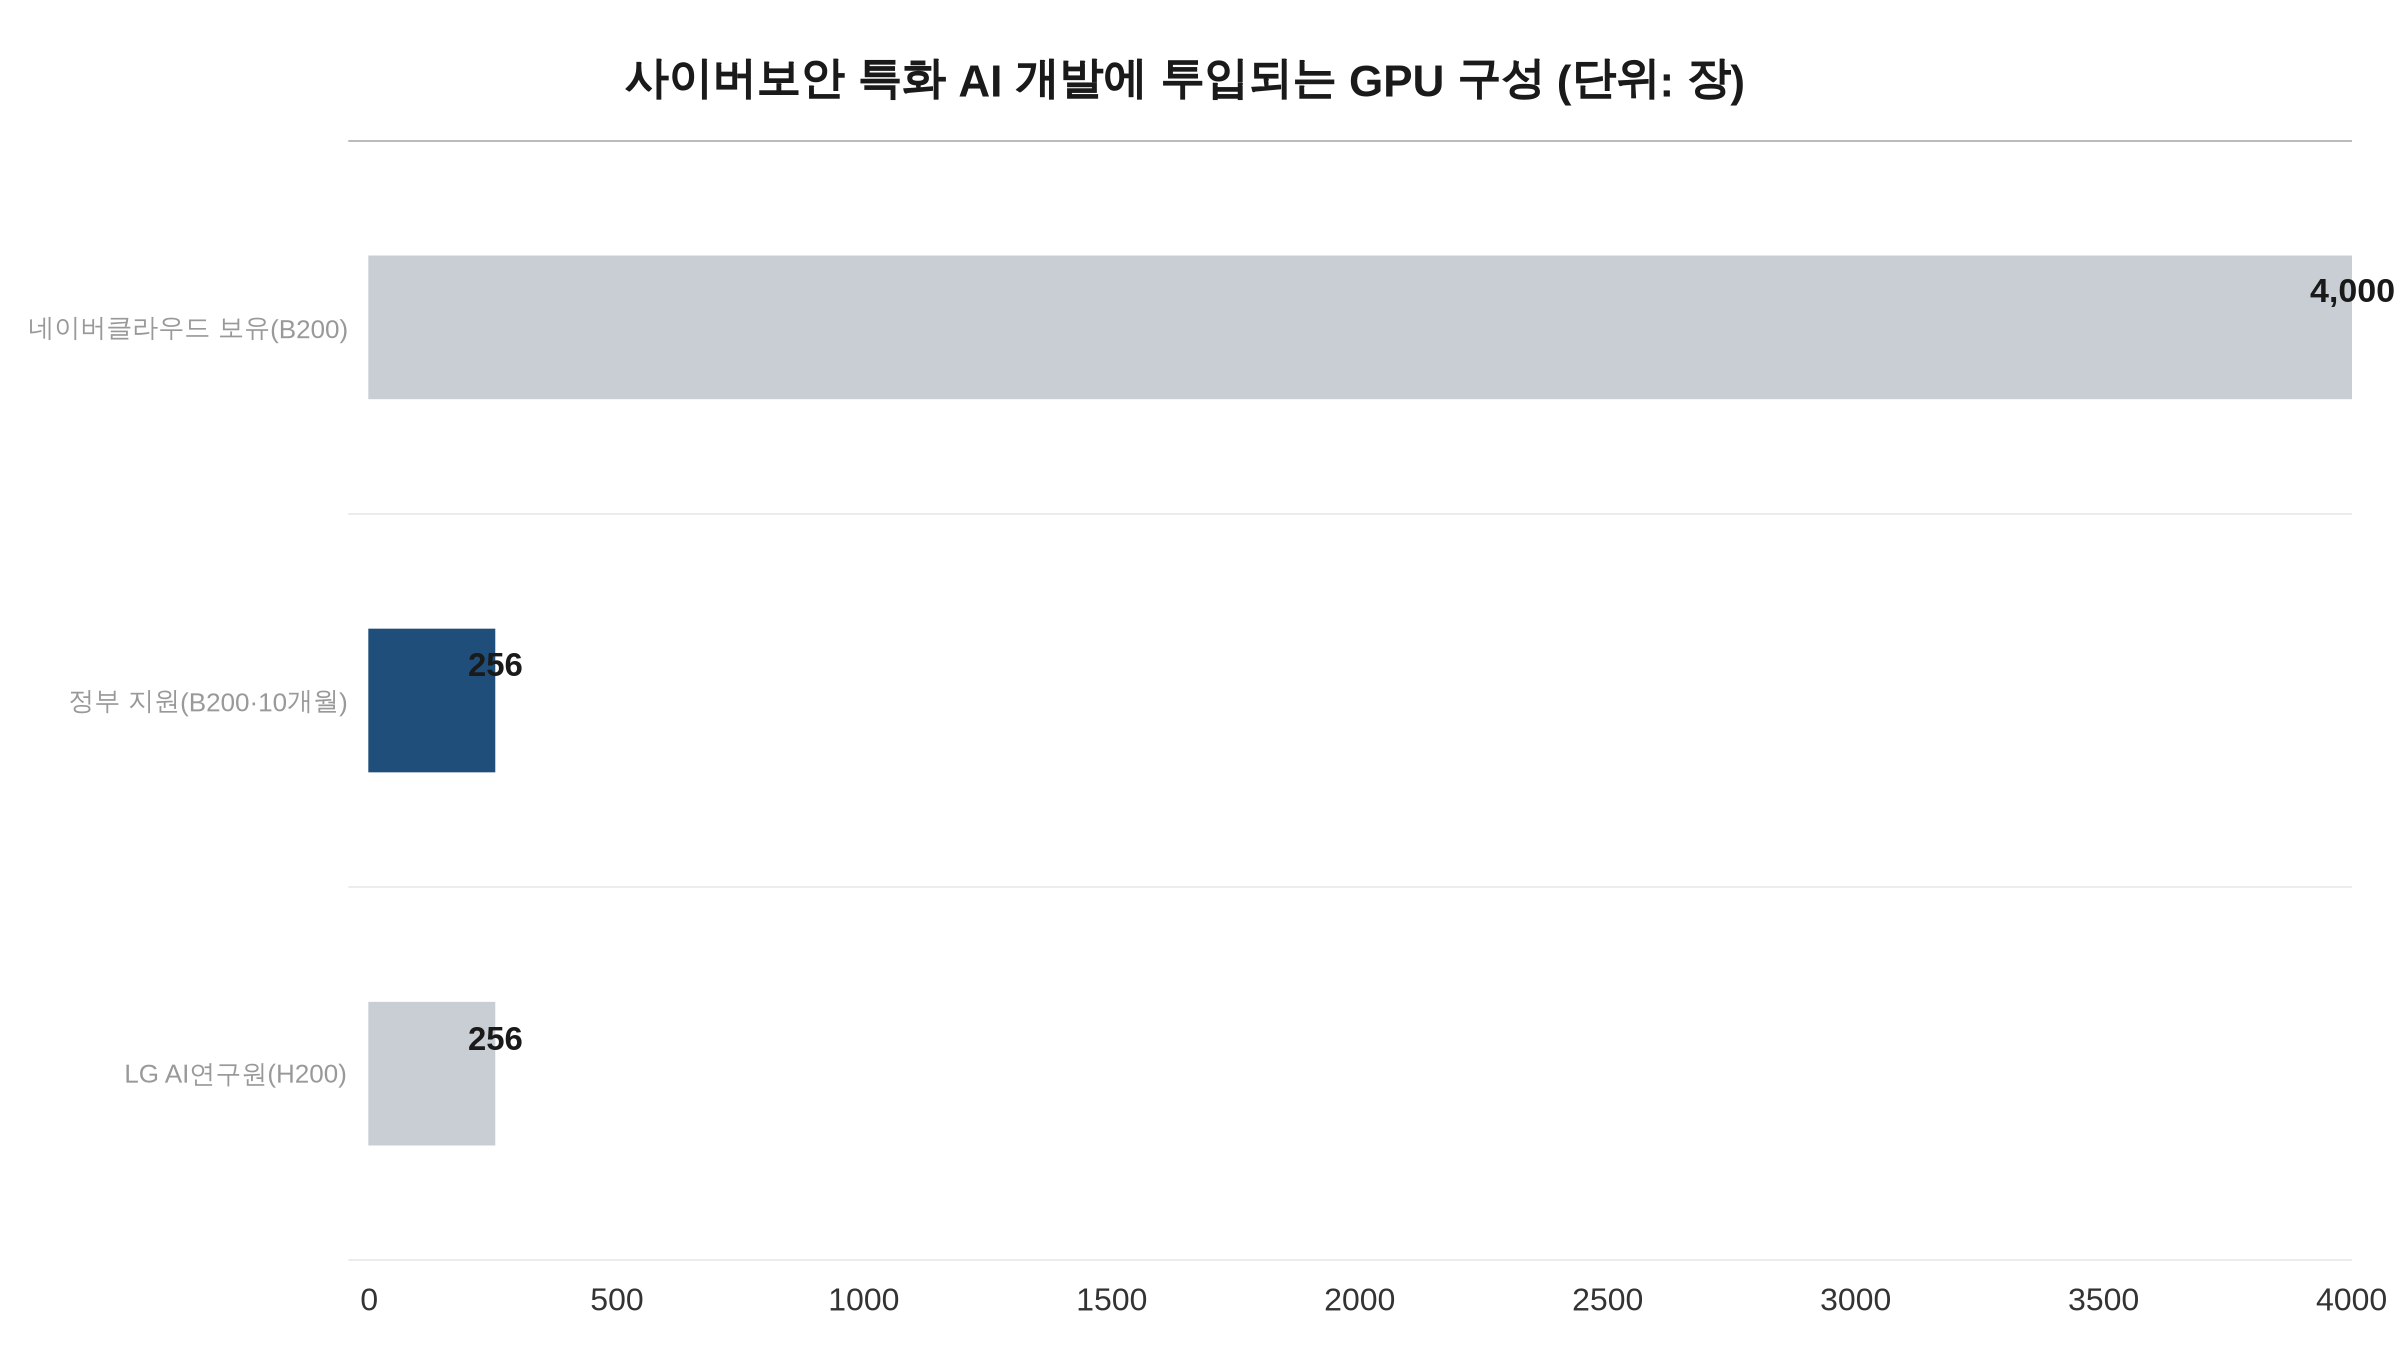
이번 사업에 투입되는 GPU는 총 4,512장이다. 네이버클라우드가 보유한 B200 4,000장에 정부가 10개월간 지원하는 B200 256장, LG AI연구원이 내놓는 H200 256장을 더했다. 이 가운데 정부 지원분 비중은 5.67%에 그친다.
학습용 보안 데이터는 약 830테라바이트(TB)다. 네이버클라우드·LG CNS·한국전력 계열·한국수력원자력·금융보안원과 통신사 운영 데이터 등 컨소시엄 참여 기관이 나눠 제공한다.
곽진 아주대 사이버보안학과 교수는 선정 전인 지난달 26일 “B200 256장을 10개월간 쓸 수 있다는 것은 적지 않은 자원이지만 프런티어급 범용 모델을 처음부터 학습할 규모는 아니다”라고 말했다.
정부가 쥔 건 자원보다 관문이다. 5개월 뒤 중간평가 결과에 따라 나머지 5개월치 지원 여부가 갈리고, 그 사이 공개되는 중간 성과 모델의 점검 결과가 지속 지원을 좌우한다. 2027년 이후 이어달리기식 후속 지원은 아직 검토 단계다. 민간이 대는 자원이 크다고 정부 역할까지 작아지지는 않는다.
성과는 무엇으로 재나…벤치마크와 실증 사이
공식 목표는 벤치마크 점수다. 이 모델을 현장에서 실제로 얼마나 쓸 수 있느냐는 별개 문제다. 곽진 교수는 같은 인터뷰에서 “성과의 우선순위는 벤치마크 점수보다 현장에서 검증된 실증 사례에 둬야 한다”고 말했다.
김유원 네이버클라우드 대표는 22일 “국방이나 공공, 통신망 관련 데이터는 우리 통제 아래 있는 보안 특화 모델이 반드시 필요하다”고 말했다. 국내 독자 모델이 필요한 이유를 데이터 주권에서 찾았다.
김승주 고려대 정보보호대학원 교수는 선정 전인 지난달 26일 “일반 사이버 보안에서는 국내 독자 모델도 여러 선택지 가운데 하나로 두고 필요에 따라 다른 모델로 교체할 수 있는 구조가 필요하다”고 말했다.
다음 관문은 2027년 2월 17일로 잡힌 1단계 평가다. 이 사업에 참여하는 협력기관 8곳의 명단은 아직 공개되지 않았다.
연관 기사